


Введение
В этой заметке я объясню, что такое метод оценки параметров с наибольшей вероятностью, и приведу простой пример для демонстрации тактики. Ряд содержания требует знания фундаментальных понятий вероятности, таких как определение вероятности и независимость событий. Я написал пост в блоге с этими предпосылками, так что будьте счастливы прочитать его, если вы считаете, что хотели бы освежиться.
Что такое параметры?
Часто в машинном обучении мы используем модель, чтобы объяснить метод, который приводит к наблюдаемой информации. Например, мы можем использовать случайную модель леса, чтобы классифицировать, могут ли клиенты отменить подписку на услугу (известную как моделирование оттока), или мы можем использовать линейную модель, чтобы предсказать доход, который будет получен корпорацией в расчете на то, какую долю они потратят на рекламу (это было бы примером линейной регрессии). Каждая модель содержит свой набор параметров, которые в конечном итоге определяют, как она будет выглядеть.
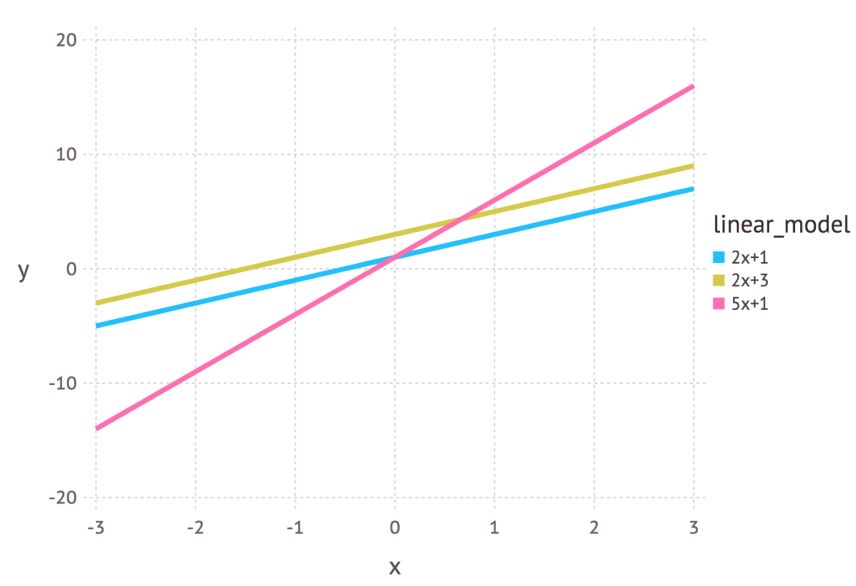
Для линейной модели мы запишем это так, что y = mx + c. В данном примере x может представлять собой расходы на рекламу, а y может быть полученным доходом. m и c являются параметрами для данной модели. Различные значения для этих параметров будут давать разные линии (см. рисунок ниже).
Поэтому параметры определяют чертеж модели. Для параметров выбираются только конкретные значения, которые мы получаем для модели, описывающей данное явление
Интуитивное объяснение оценки максимальной вероятности
Оценка максимальной вероятности может быть методом, определяющим значения параметров модели. Значения параметров находят такие, что они максимизируют вероятность того, что метод, описанный моделью, выдал информацию, которая фактически наблюдалась.
Приведенное выше определение должно звучать загадочно, поэтому давайте рассмотрим пример, чтобы помочь понять это.
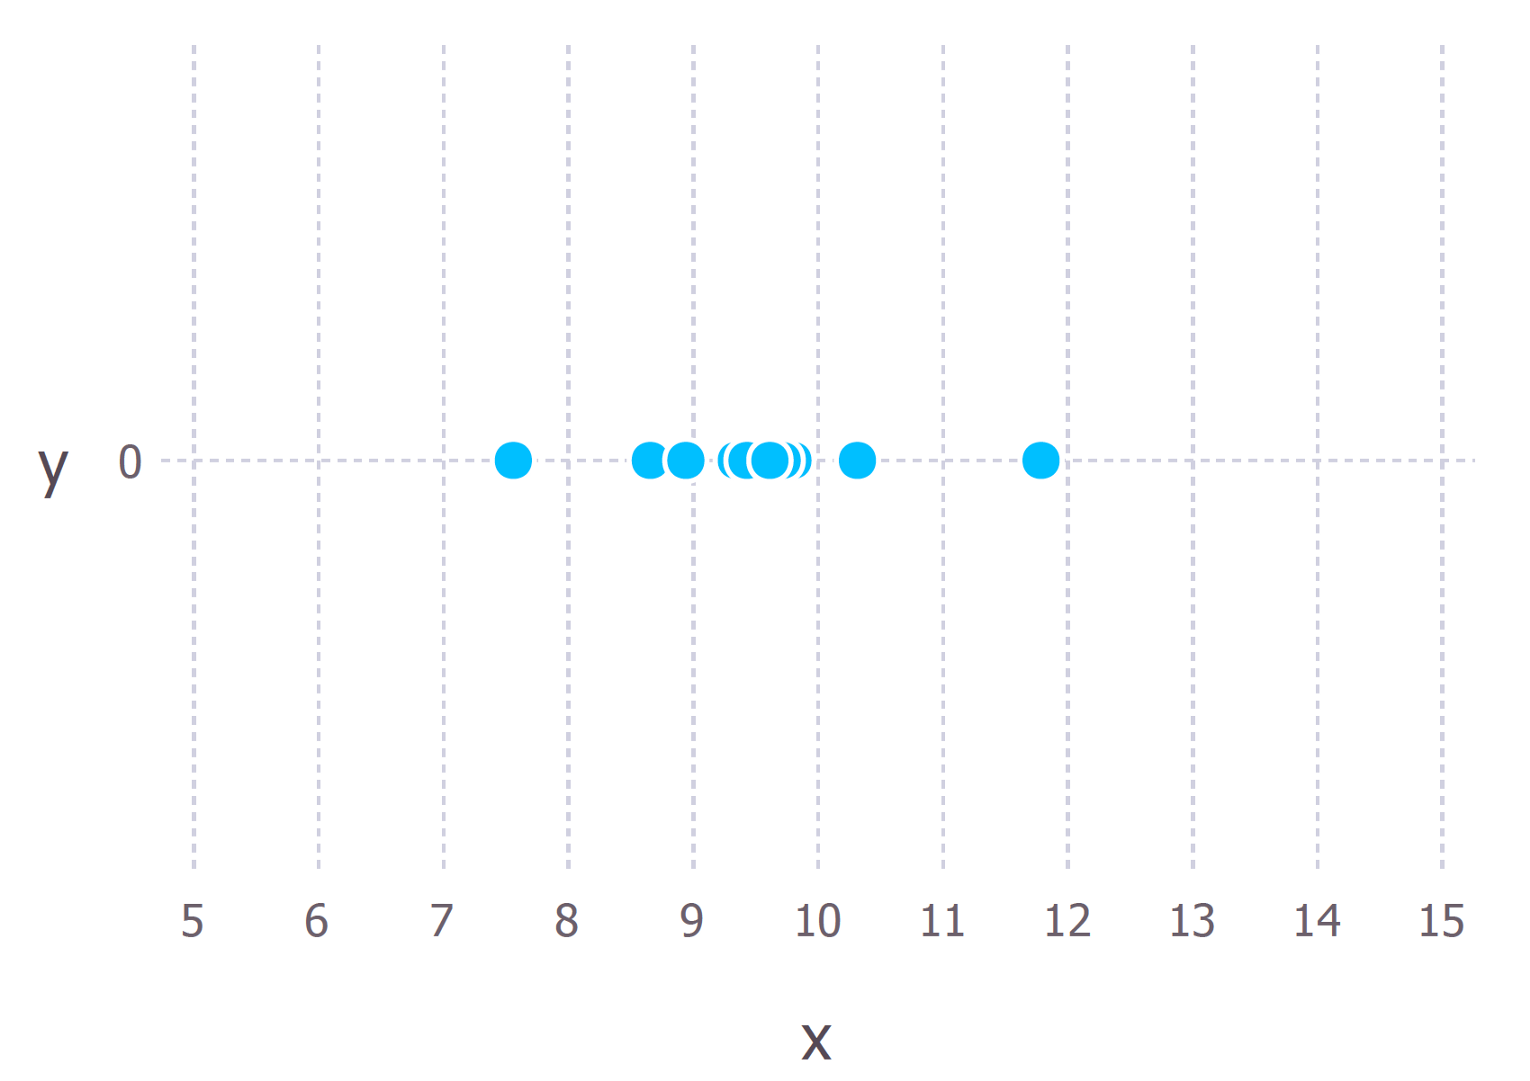
Допустим, мы наблюдали 10 точек данных от какого-то процесса. Например, каждая точка данных может представлять собой длительность времени в секундах, которое требуется студенту, чтобы ответить на выбранный вопрос экзамена. Эти 10 точек данных показаны на рисунке ниже
Сначала нужно решить, какая модель лучше всего описывает метод генерации информации. Эта часть чрезвычайно важна. По крайней мере, мы всегда должны иметь честное представление о том, какую модель использовать. Обычно это происходит от того, что у нас есть некоторый опыт в области, но мы не будем обсуждать это здесь.
Для этих данных мы предположим, что процесс генерации информации часто адекватно описывается гауссовским (нормальным) распределением. Визуальный осмотр рисунка выше показывает, что нормальное распределение правдоподобно, так как большинство из десяти точек сгруппированы внутри середины с небольшим количеством точек, разбросанных влево, а, следовательно, и вправо. (Принимать такое решение на лету с 10 точками данных нецелесообразно, но пока я генерирую эти точки данных, мы будем сопровождать его).
Напомним, что нормальное распределение имеет 2 параметра. Среднее, μ, и, следовательно, дисперсия, σ. Различные значения этих параметров оканчиваются на разных кривых (так же, как и на прямых выше). Хотелось бы понять, какая кривая предположительно ответственна за создание информационных точек, которые мы наблюдали? (См. рисунок ниже). Максимальная оценка вероятности может быть методом, который найдет значения μ и σ, которые заканчиваются на кривой, наиболее близкой к информации.
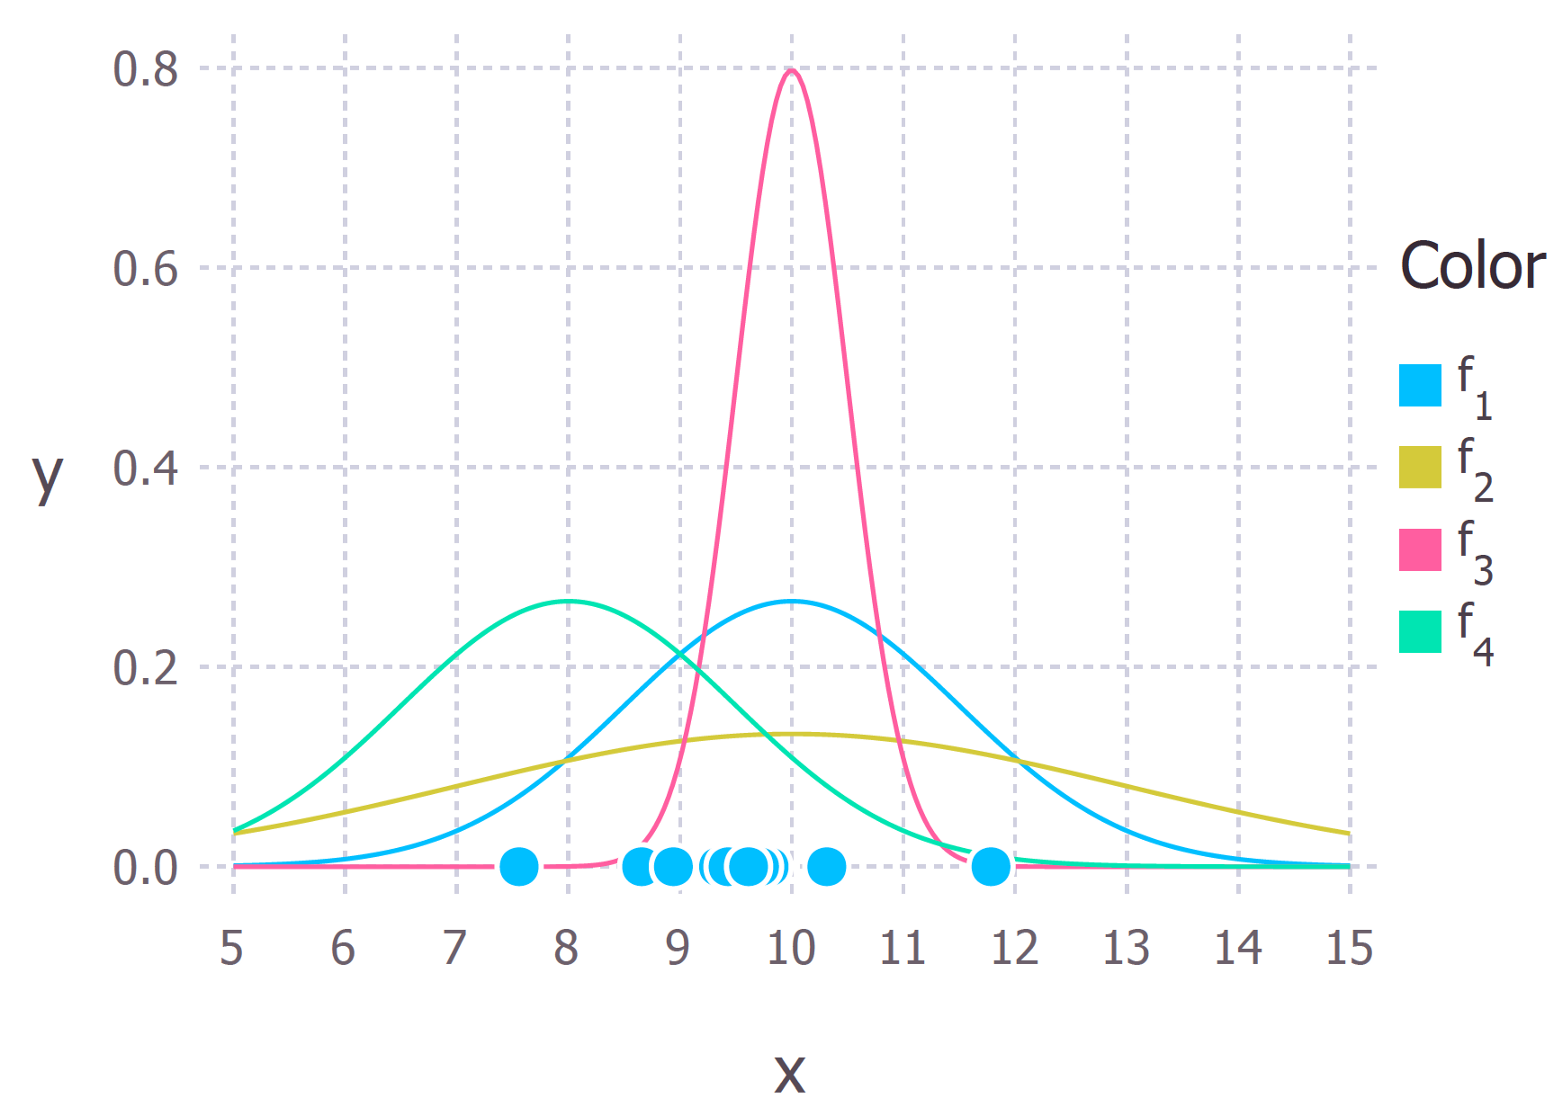
Истинное распределение, из которого была сгенерирована информация, было f1 ~ N(10, 2.25), т.е. синяя кривая в пределах рисунка выше.
Вычисление максимальной вероятностной оценки
Теперь, когда у нас есть интуитивное понимание того, что такое оценка максимальной вероятности, мы перейдем к изучению способа вычисления значений параметров. Значения, которые мы обнаруживаем, называются оценками максимального правдоподобия (MLE).
Мы еще раз продемонстрируем это на примере. Предположим, что мы имеем три точки данных в этой точке и предполагаем, что они должны быть сгенерированы из процесса, адекватно описанного нормальным распределением. Это точки 9, 9.5 и 11. Как вычислить оценки максимальной вероятности значений параметров нормального распределения μ и σ?
Хотелось бы вычислить, что общая вероятность наблюдения всей информации, т.е. вероятностное распределение всех наблюдаемых точек данных. Чтобы попробовать это вычислить некоторые условные вероятности, которые могут оказаться очень сложными. Поэтому здесь мы сделаем наше первое предположение. Идея заключается в том, что каждая точка данных генерируется независимо от других. Это предположение значительно облегчает математику. Если события (т.е. метод, который генерирует данные) являются независимыми, то вся вероятность наблюдения за всеми знаниями заключается в том, что продукт наблюдения за каждой данной в отдельности (т.е. товар предельных вероятностей).
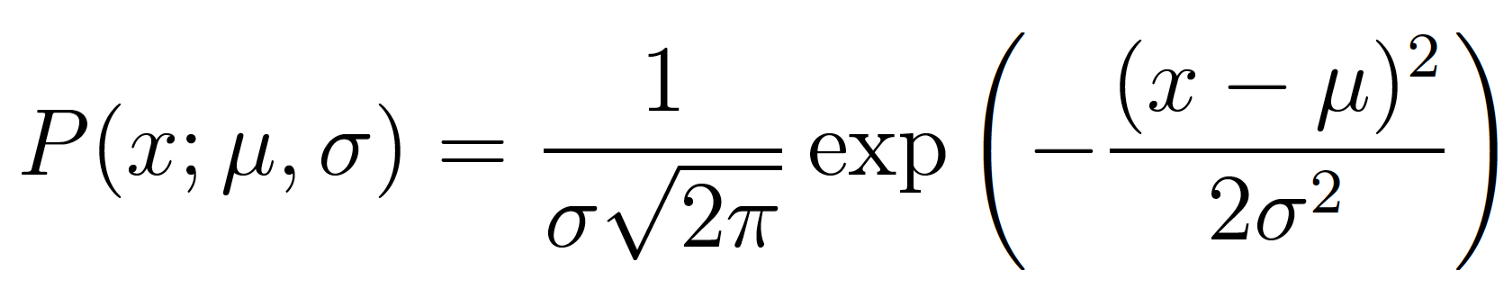
Приводится плотность вероятности наблюдения одной точки отсчета x, генерируемой из нормального распределения:
Полудвоеточие, используемое в нотации P(x; μ, σ), служит для того, чтобы подчеркнуть, что символы, которые появляются после него, являются параметрами распределения вероятности. Поэтому не следует путать с условной вероятностью (которая обычно представлена вертикальной линией, например, P(A| B)).

В нашем примере приведена вся (совместная) плотность вероятности наблюдения за тремя точками данных:
Нужно лишь узнать значения μ и σ, что приводит к выдаче максимального значения вышеприведенного выражения.
Если вы занимались вычислениями в математических классах, то наверняка помните, что есть способ, который поможет нам найти максимумы (и минимумы) функций. Это называется дифференциация. Все, что мы делаем, это пытаемся найти производную функции, установить производную функции на ноль, затем переставить уравнение, чтобы сформировать интересующий параметр темы уравнения. И вуаля, у нас будут значения MLE для наших параметров. Сейчас я пройду эти этапы, но буду считать, что читатель знает, как проводить дифференциацию по общим функциям. Если вы дадите более подробное объяснение, просто дайте мне знать в комментариях.
Журнал вероятности


Вышеприведенное выражение для всей вероятности действительно довольно болезненно для дифференциации, поэтому оно почти всегда упрощается путем взятия логарифма-напиериана выражения. Часто это абсолютно нормально, так как напиеровский логарифм может быть монотонно нарастающей функцией. Это говорит о том, что если значение по оси x увеличивается, то значение по оси y также увеличивается (см. рисунок ниже). Это часто важно, потому что это гарантирует, что максимальное значение логарифма вероятности происходит в эквивалентной точке, потому что исходная функция вероятности. Поэтому мы будем работать с более простой вероятностью журнала, а не с первой вероятностью. Взятие журнала первого выражения дает нам:
Это выражение часто снова упрощается, используя законы логарифмов для получения:


Это выражение часто дифференцируется, чтобы найти максимум. В этом примере мы найдем MLE среднего, μ. чтобы попробовать, мы возьмем часть функции со ссылкой на μ, давая

Наконец, установка левой стороны уравнения на ноль и переупорядочивание на μ дает:
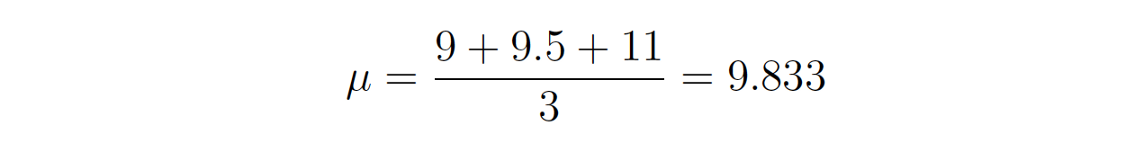
И там у нас есть максимальная оценка вероятности для μ. мы сделаем эквивалент с σ тоже, но я оставлю это как упражнение для увлеченного читателя.
Заключительные замечания
Всегда ли оценка максимальной вероятности может быть решена определенным образом?
Нет, это короткий ответ. Скорее всего, во время мирового сценария производная функции лога-вероятности остается аналитически неразрешимой (т.е. слишком трудно/невозможно дифференцировать функцию вручную). Поэтому итерационные методы, такие как алгоритмы Expectation-Maximization, не позволяют найти численные решения для оценки параметров. Однако общая идея остается эквивалентной.
Так почему же максимальная вероятность, а не максимальная вероятность?
Ну, часто это всего лишь педантизм статистиков (но навсегда разумеется). Большинство людей склонны использовать вероятность и вероятность как взаимозаменяемые, но статистики и теоретики вероятности различают 2. Обоснование путаницы лучше всего выделяют, наблюдая за уравнением.
Эти выражения равны! Так что же это значит? Давайте сначала определим P(data; μ, σ)? Это означает “плотность вероятности наблюдения за информацией с параметрами модели μ и σ”. Стоит заметить, что мы обобщим это на любое количество параметров и на любое распределение.
С противоположной стороны L(μ, σ; данные) означает “вероятность того, что параметры μ и σ будут иметь определённые значения, если мы наблюдали кучу знаний”.
Вышеприведенное уравнение говорит о том, что плотность вероятности информации, приведенной в параметрах, адекватна вероятности параметров, приведенных в информации. Но, несмотря на то, что эти две вещи равны, вероятность и, следовательно, плотность вероятности принципиально задают разные вопросы – один задается информацией, а другой – значениями параметров. Часто поэтому тактику называют максимальной вероятностью, а не максимальной вероятностью.
Когда метод минимизации наименьших квадратов эквивалентен оценке максимальной вероятности?
Минимизация по методу наименьших квадратов является еще одним распространенным методом оценки значений параметров для модели в машинном обучении. Представляется, что когда модель, как и в приведенных выше примерах, считается гауссовской, то оценки МЛЭ похожи на метод наименьших квадратов. Для более глубокого математического анализа этих слайдов.
Интуитивно мы будем интерпретировать связь между двумя методами, понимая их цели. Для метода оценки параметров наименьших квадратов мы хотим найти дорогу, которая минимизирует все квадратные расстояния между информационными точками и, следовательно, кривую регрессии (см. рисунок ниже). В оценке максимальной вероятности мы бы хотели максимизировать всю вероятность информации. Когда предполагается нормальное распределение, максимальная вероятность найдется, когда информационные точки встречаются со средним значением. Так как нормальное распределение симметрично, то часто это похоже на минимизацию пространства между инфопунктами и, следовательно, средним значением.
You may also like
Ложное отрицание
При понимании гипотезы две ошибки могут сбить с толку. Эти две ошибки – ложноотрицательная и ложноположительная. Ложноотрицательную ошибку можно также назвать ошибкой второго типа, а ложноположительную – ошибкой первого типа. В процессе обучения вы можете подумать, что эти ошибки не имеют никакого смысла и только зря потратите время на изучение концепций. Однако, рассмотрев преимущества этих […]
Обзор сюжета коробки
График ящиков или ящиков, а также график вискеров помогут вам отобразить распределение базы данных в виде сводки из пяти чисел. Первый квартиль Q1 будет минимальным, третий квартиль Q3 – медианным, пятый квартиль Q5 – максимальным. Вы можете узнать пропуски и их значения, используя график ящиков. Вы также можете понять, симметричны ли Ваши данные, плотно ли […]

Байесские сети
Создание вероятностной модели может быть сложным делом, но окажется полезным в процессе обучения на станке. Для создания такой графической модели необходимо найти вероятностные связи между переменными. Предположим, вы создаете графическое представление переменных. Нужно представить переменные как узлы, а условную независимость – как отсутствие ребер. Графические модели, такие как байесовские статистические модели, становятся все более популярными […]
